RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp mô hình AI tạo sinh với một hệ thống truy xuất thông tin bên ngoài. Thay vì chỉ dựa vào kiến thức đã được lưu trong các tham số của mô hình từ quá trình huấn luyện, hệ thống có thể tìm thêm tài liệu liên quan, đưa chúng vào ngữ cảnh và sau đó mới tạo câu trả lời.
Đây là một trong những cơ chế quan trọng giúp AI trả lời những câu hỏi cần thông tin mới, dữ liệu nội bộ hoặc nội dung cụ thể từ một website mà không phải huấn luyện lại toàn bộ mô hình.
Google hiện xác nhận các tính năng AI tạo sinh trong Google Search như AI Overviews và AI Mode sử dụng Retrieval-Augmented Generation, hay grounding, kết hợp với hệ thống xếp hạng cốt lõi của Search để lấy các trang web liên quan và cập nhật trước khi tạo phản hồi. Các trang được sử dụng làm nguồn hỗ trợ có thể xuất hiện dưới dạng liên kết có thể nhấp trong câu trả lời.
Với doanh nghiệp làm SEO và GEO, điều này dẫn đến một thay đổi quan trọng trong cách nhìn về content:
Nội dung không chỉ cần được viết tốt. Nó còn cần được Google hoặc hệ thống tìm kiếm tương ứng có thể khám phá, hiểu là liên quan và chọn làm nguồn hỗ trợ cho đúng câu hỏi.
Tuy nhiên, RAG không phải một “thuật toán GEO” mà doanh nghiệp có thể tối ưu trực tiếp. Không có chỉ số công khai cho biết một bài đang có “điểm RAG” bao nhiêu, cũng không thể bắt buộc AI phải lấy website của mình làm nguồn.
RAG là gì và cách AI dùng dữ liệu ngoài để trả lời
RAG là gì?
RAG là viết tắt của Retrieval-Augmented Generation, có thể hiểu là tạo sinh được tăng cường bằng truy xuất thông tin.
Khái niệm RAG được phổ biến qua nghiên cứu Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks của Patrick Lewis và các cộng sự năm 2020. Nghiên cứu đề xuất kết hợp hai loại “bộ nhớ”:
Thành phần
Có thể hiểu đơn giản là gì?
Parametric memory
Kiến thức đã được học và lưu trong tham số của mô hình
Non-parametric memory
Kho dữ liệu bên ngoài có thể được tìm kiếm khi cần
Retriever
Thành phần tìm tài liệu liên quan
Generator
Mô hình dùng câu hỏi và tài liệu vừa tìm được để tạo câu trả lời
Trong mô hình RAG ban đầu, kho dữ liệu bên ngoài là một dense vector index của Wikipedia. Retriever tìm các đoạn liên quan rồi generator sử dụng chúng cùng với câu hỏi để tạo kết quả.
Điểm khác biệt cốt lõi so với mô hình chỉ dùng kiến thức huấn luyện nằm ở khả năng truy cập nguồn bên ngoài tại thời điểm xử lý câu hỏi.
Có thể hình dung:
AI không dùng RAG:
Câu hỏi
↓
Kiến thức đã học trong mô hình
↓
Câu trả lời
Trong khi với RAG:
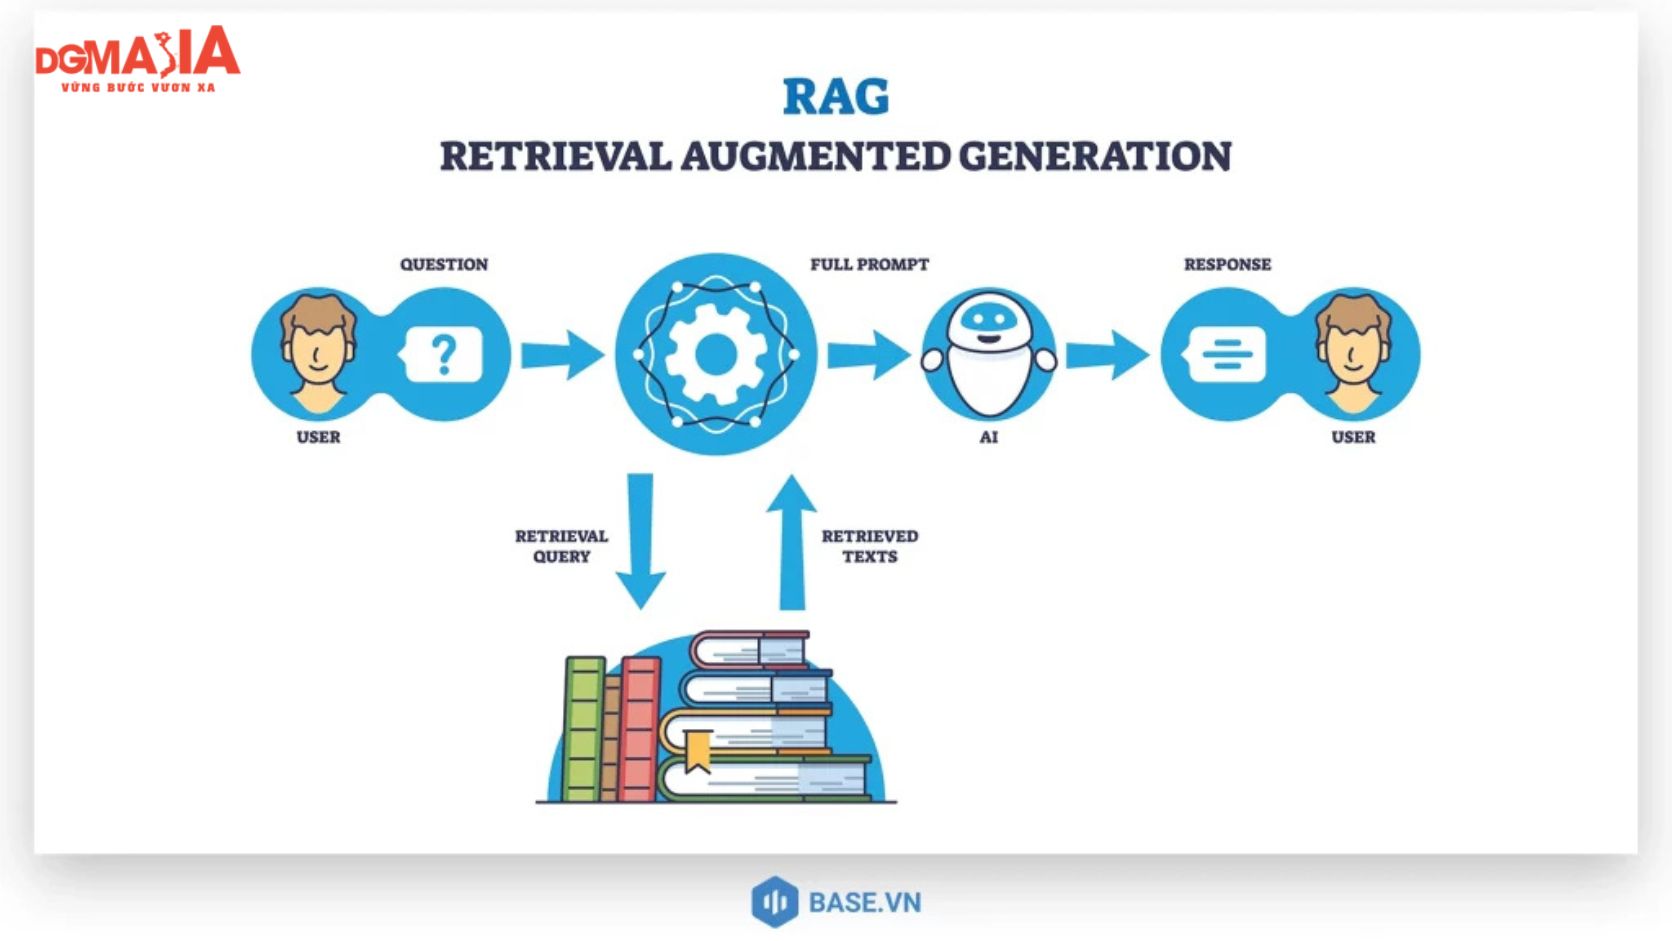
Câu hỏi
↓
Tìm nguồn dữ liệu liên quan
↓
Lấy thông tin phù hợp
↓
Đưa câu hỏi + thông tin vào LLM
↓
Tạo câu trả lời
↓
Có thể kèm nguồn hỗ trợ
AWS định nghĩa RAG theo hướng tương tự: một thành phần truy xuất lấy thông tin từ nguồn bên ngoài dữ liệu huấn luyện, sau đó câu hỏi và thông tin liên quan được đưa cho LLM để tạo phản hồi tốt hơn.
Vì sao RAG trở nên quan trọng khi AI Search phát triển?
LLM truyền thống có một hạn chế quan trọng: kiến thức trong mô hình phụ thuộc vào dữ liệu đã được sử dụng để huấn luyện.
Giả sử một doanh nghiệp thay đổi:
Bảng giá vào tháng này.
Chính sách bảo hành hôm qua.
Dòng sản phẩm mới trong tuần này.
Giám đốc điều hành mới.
Dữ liệu nghiên cứu vừa công bố.
Không thể liên tục huấn luyện lại mô hình lớn mỗi khi một website trên Internet thay đổi thông tin.
RAG giải quyết vấn đề bằng cách cho AI tìm dữ liệu bên ngoài tại thời điểm cần trả lời.
Google Cloud nêu ba lợi ích quan trọng của RAG: truy cập thông tin mới, grounding câu trả lời vào dữ liệu thực tế và cung cấp thông tin phù hợp hơn với ngữ cảnh cụ thể.
Ví dụ đơn giản
Người dùng hỏi:
DGMASIA hiện cung cấp những dịch vụ Digital Marketing nào?
Một mô hình chỉ dựa vào dữ liệu huấn luyện có thể:
Không biết DGMASIA.
Biết thông tin cũ.
Tự suy luận dựa trên tên thương hiệu.
Trộn thông tin của doanh nghiệp khác.
Một hệ thống có khả năng truy xuất web có thể làm:
Câu hỏi
↓
Tìm website và các nguồn liên quan đến DGMASIA
↓
Truy xuất trang chủ/trang dịch vụ
↓
Xác định các dịch vụ được công bố
↓
Tạo câu trả lời
↓
Dẫn nguồn về website
RAG vì vậy cho phép hệ thống xử lý những thông tin không cần nằm sẵn trong trọng số mô hình.
Cơ chế này ra đời cùng lúc với sự thay đổi trong thói quen tra cứu của người dùng. Bài AI đang thay đổi cách dùng Internet như thế nào mô tả xu hướng đặt câu hỏi dài và mang tính hội thoại, lý do khiến hệ thống phải truy xuất nhiều nguồn cho một truy vấn thay vì trả về một danh sách liên kết.
RAG hoạt động như thế nào?
Bốn giai đoạn hoạt động của một hệ thống RAG
Một hệ thống RAG thực tế có thể phức tạp, nhưng với người làm marketing có thể hiểu theo bốn giai đoạn:
Giai đoạn
Hệ thống làm gì?
1. Chuẩn bị dữ liệu
Thu thập và xử lý tài liệu
2. Retrieval
Tìm tài liệu phù hợp với câu hỏi
3. Augmentation
Đưa tài liệu vào context của mô hình
4. Generation
Tạo câu trả lời dựa trên câu hỏi và context
Giai đoạn 1: Chuẩn bị nguồn dữ liệu
Nguồn bên ngoài có thể là:
Website công khai.
Tài liệu doanh nghiệp.
Knowledge base.
Database.
API.
File PDF.
Chính sách nội bộ.
Catalogue.
Danh mục sản phẩm.
Trong một hệ thống RAG sử dụng vector search, tài liệu thường được xử lý thành các đơn vị nội dung và chuyển thành embedding để lưu trong vector index.
Google Cloud có tài liệu minh họa pipeline với PDF theo hướng:
Phân tích PDF → tách nội dung → tạo embedding → vector search → đưa kết quả vào prompt → tạo phản hồi bằng AI.
Tuy nhiên, cần lưu ý:
RAG không bắt buộc phải dùng vector database.
Một hệ thống có thể truy xuất bằng:
Keyword search.
Full-text search.
Semantic/vector search.
Database query.
API.
Knowledge graph.
Hybrid search.
Công cụ tìm kiếm web.
Kết hợp nhiều phương pháp.
Google Cloud cho biết các hệ thống tìm kiếm hiện đại có thể kết hợp semantic search, keyword search và reranker để tăng độ liên quan trước khi đưa kết quả vào bước tạo sinh.
Vì vậy, công thức:
RAG = Vector Search + LLM
là một cách mô tả đơn giản nhưng không đầy đủ.
Cách chính xác hơn là:
RAG = Retrieval + dữ liệu được truy xuất + mô hình tạo sinh.
Vector Search chỉ là một trong những cách thực hiện phần Retrieval.
Giai đoạn 2: Retrieval – tìm thông tin liên quan
Đây là bước hệ thống xác định những tài liệu nào có khả năng giúp trả lời câu hỏi.
Trong RAG gốc năm 2020, truy vấn và tài liệu được biểu diễn thành dense vector. Retriever sử dụng Maximum Inner Product Search để tìm các tài liệu gần truy vấn nhất.
Với một hệ thống hiện đại, retrieval có thể phức tạp hơn:
Câu hỏi
↓
Phân tích intent
↓
Viết lại/mở rộng truy vấn
↓
Keyword Search + Vector Search
↓
Áp dụng bộ lọc
↓
Lấy một tập kết quả
↓
Reranker đánh giá lại
↓
Chọn nguồn phù hợp nhất
Đây là lý do chất lượng của hệ thống truy xuất đặc biệt quan trọng.
Google Cloud nhấn mạnh rằng nếu phần retrieval trả về dữ liệu không liên quan, câu trả lời vẫn có thể được “grounded” vào dữ liệu nhưng kết quả lại sai chủ đề hoặc không chính xác.
Ví dụ
Người dùng hỏi:
Doanh nghiệp nhỏ nên tuyển marketing in-house hay thuê agency?
Hệ thống có thể tìm những nội dung như:
Nội dung
Mức liên quan
In-house Marketing và Agency khác nhau thế nào?
Rất cao
Chi phí xây phòng Marketing SME
Cao
Khi nào nên thuê Digital Marketing Agency?
Cao
Marketing là gì?
Thấp hơn
Cách tuyển nhân viên SEO
Chỉ liên quan một phần
Nếu bài của doanh nghiệp chỉ nhắc “in-house” một lần nhưng thực chất nói về vấn đề khác, việc chèn thêm từ khóa không bảo đảm bài sẽ được lựa chọn.
Giai đoạn 3: Augmentation – đưa dữ liệu vào context
Sau retrieval, thông tin được chọn sẽ được đưa cùng câu hỏi vào ngữ cảnh của mô hình.
Ví dụ đơn giản hóa:
Câu hỏi:
Doanh nghiệp mới có nên làm SEO ngay không?
Nguồn truy xuất:
Tài liệu A: SEO phù hợp khi đã tồn tại nhu cầu tìm kiếm.
Tài liệu B: Sản phẩm mới chưa có search demand có thể cần demand generation.
Tài liệu C: SEO thường cần thời gian tích lũy.
Yêu cầu mô hình:
Dựa trên các nguồn trên, trả lời câu hỏi của người dùng.
Mô hình không cần “học thuộc” lại các tài liệu này. Chúng chỉ được bổ sung vào context cho lần xử lý hiện tại.
Đây là lý do RAG có thể đưa dữ liệu mới vào câu trả lời nhanh hơn so với huấn luyện lại mô hình.
Giai đoạn 4: Generation – tạo câu trả lời
LLM sử dụng:
Câu hỏi của người dùng.
Instructions của hệ thống.
Dữ liệu vừa truy xuất.
Kiến thức và khả năng ngôn ngữ đã học.
để tạo phản hồi cuối cùng.
AWS mô tả quá trình này là đưa user query và thông tin liên quan từ nguồn ngoài vào LLM để mô hình sử dụng cả kiến thức mới lẫn khả năng tạo ngôn ngữ của mình.
Một số hệ thống còn yêu cầu mô hình:
Chỉ trả lời từ nguồn.
Trích nguồn theo từng câu.
Từ chối nếu không đủ bằng chứng.
Đánh giá độ tin cậy.
So sánh nhiều nguồn.
Ưu tiên dữ liệu mới hơn.
Nhưng cách triển khai khác nhau giữa từng sản phẩm.
RAG có phải cơ chế đứng sau Google AI Overviews và AI Mode không?
Có, theo tài liệu Google Search Central hiện tại.
Google công bố rằng các tính năng AI tạo sinh trong Search dựa trên hệ thống xếp hạng và chất lượng cốt lõi của Google Search, đồng thời sử dụng các kỹ thuật gồm:
Kỹ thuật
Vai trò
RAG/grounding
Lấy các trang web liên quan và cập nhật từ Search index
Query fan-out
Tạo nhiều truy vấn liên quan để tìm thêm thông tin
Core ranking systems
Đánh giá và truy xuất các kết quả phù hợp
Generative model
Tổng hợp thông tin thành câu trả lời
Google mô tả RAG trong Search là kỹ thuật giúp cải thiện chất lượng, độ chính xác và độ mới bằng cách sử dụng hệ thống xếp hạng cốt lõi để truy xuất các trang web phù hợp trong Search index. Sau đó hệ thống xem thông tin cụ thể trên các trang được truy xuất để tạo phản hồi, đồng thời hiển thị các liên kết hỗ trợ.
Điểm này đặc biệt quan trọng với SEO/GEO:
Google AI Search không vận hành như một vector database đơn giản quét từng đoạn trên Internet.
Nó vẫn dựa trên Search index, hệ thống crawl/index và các tín hiệu xếp hạng chất lượng của Google.
Do đó, các nguyên tắc SEO nền tảng vẫn áp dụng.
Query fan-out liên quan thế nào đến RAG?
Một người có thể hỏi một câu tương đối rộng:
Làm SEO hay chạy Google Ads tốt hơn cho doanh nghiệp nhỏ?
Thay vì chỉ tìm đúng câu đó, AI Search có thể tạo các truy vấn phụ như:
chi phí SEO doanh nghiệp nhỏ
bao lâu SEO có kết quả
Google Ads cost SME
SEO vs PPC lead quality
khi nào nên dùng Google Ads
Google gọi đây là query fan-out: tạo đồng thời nhiều truy vấn liên quan để thu thập thêm kết quả và giải quyết đầy đủ câu hỏi gốc.
Điều này giải thích tại sao một câu trả lời AI có thể dẫn nhiều nguồn khác nhau thay vì chỉ dựa vào một bài duy nhất.
Với doanh nghiệp, bài học không phải là tạo riêng một bài cho mọi fan-out query. Google thậm chí cảnh báo không nên sản xuất hàng loạt trang chỉ để bao phủ mọi biến thể truy vấn AI.
Thay vào đó, cần xây một cụm nội dung có chiều sâu và giá trị thật.
RAG khác gì kiến thức AI đã học sẵn?
Hai nguồn kiến thức thường được gọi là parametric knowledge và retrieved/non-parametric knowledge.
Tiêu chí
Kiến thức đã huấn luyện
RAG
Nằm ở đâu?
Trong tham số mô hình
Nguồn bên ngoài
Khả năng cập nhật
Cần huấn luyện/cập nhật mô hình
Có thể thay đổi nguồn nhanh
Gắn với nguồn cụ thể
Khó hơn
Có thể
Dữ liệu riêng doanh nghiệp
Không mặc định có
Có thể kết nối
Thông tin mới
Có thể thiếu
Có thể truy xuất
Khả năng trích dẫn
Không tự nhiên có provenance
Có thể dẫn về nguồn truy xuất
Nghiên cứu RAG ban đầu nhấn mạnh một số hạn chế của parametric knowledge: khó cập nhật bộ nhớ, khó cung cấp provenance và có thể hallucinate.
Doanh nghiệp có thể tác động phần nào?
Doanh nghiệp gần như không kiểm soát việc dữ liệu nào đã nằm trong quá trình huấn luyện của một mô hình thương mại.
Nhưng với hệ thống retrieval từ web, doanh nghiệp có thể tác động gián tiếp đến khả năng được tìm thấy thông qua:
Website có thể crawl.
URL được index.
Nội dung liên quan đúng nhu cầu.
Thông tin chính xác.
Trang có nguồn và bằng chứng.
Thương hiệu và dịch vụ được diễn đạt nhất quán.
Internal link rõ.
Nội dung còn cập nhật.
Đây là phần có ý nghĩa hơn với SEO/GEO.
Ngược lại, nếu một trang không bao giờ lọt vào bước retrieval thì mọi nỗ lực biên tập đều không có tác dụng. Bài vì sao website không được AI Search trích dẫn liệt kê các nguyên nhân kỹ thuật thường gặp như chặn crawler, nội dung chỉ render bằng JavaScript hoặc trang chưa được index.
Vì sao RAG quan trọng với GEO?
Có thể hình dung hành trình của một trang trong Google AI Search như sau:
Website
↓
Google crawl
↓
Google index
↓
Người dùng đặt câu hỏi
↓
Query fan-out / retrieval
↓
Trang được chọn làm nguồn liên quan
↓
Thông tin trên trang được xem xét
↓
AI tạo câu trả lời
↓
Website có thể được hiển thị dưới dạng nguồn hỗ trợ
Nếu trang không vượt qua những bước đầu như crawl và index, việc tối ưu câu chữ để “AI dễ trích dẫn” không giải quyết được vấn đề.
Google nói rõ một trang muốn đủ điều kiện xuất hiện trong generative AI features phải được index và đủ điều kiện hiển thị trên Search với snippet. Việc đáp ứng yêu cầu cũng không bảo đảm chắc chắn trang sẽ được crawl, index hoặc phục vụ.
Nội dung được truy xuất mới có cơ hội trở thành nguồn
Với một câu trả lời grounded vào web, hệ thống phải xác định được một trang hoặc nguồn là liên quan trước khi có thể sử dụng thông tin của trang đó làm bằng chứng.
Do đó, có thể tách GEO thành hai vấn đề:
Giai đoạn
Câu hỏi cần giải quyết
Discovery
Hệ thống có tìm và index được trang không?
Retrieval
Trang có được xem là liên quan đến câu hỏi không?
Evidence
Thông tin trong trang có đủ rõ và đáng tin để sử dụng không?
Citation/link
Trang có được chọn làm nguồn hỗ trợ trong phản hồi không?
Conversion
Người dùng bấm link có thực hiện hành động tiếp không?
Không nên chỉ tập trung vào bước citation cuối cùng.
RAG có luôn dùng Vector Search không?
Không.
Mô hình RAG gốc sử dụng dense vector retrieval. Nhiều hệ thống RAG hiện nay cũng sử dụng embedding và vector database vì đây là phương pháp hiệu quả để tìm nội dung gần nghĩa. Google Cloud mô tả modern search engines có thể lưu embeddings trong vector database và tìm dữ liệu dựa trên semantic similarity.
Nhưng RAG có thể dùng nhiều phương pháp retrieval.
Phương pháp
Mạnh khi
Keyword Search
Tên, mã, thuật ngữ chính xác
Vector Search
Cách diễn đạt khác nhau nhưng gần nghĩa
Hybrid Search
Cần cả semantic và keyword
SQL/database
Câu hỏi về dữ liệu có cấu trúc
API
Cần dữ liệu thời gian thực
Web Search
Cần thông tin công khai, mới
Knowledge graph
Cần quan hệ giữa thực thể
Một hệ thống tốt thường chọn phương pháp retrieval phù hợp với loại dữ liệu.
Vì vậy, doanh nghiệp không nên hiểu:
AI Search dùng RAG → RAG dùng vector → phải “SEO vector”.
Đây là một chuỗi suy luận đơn giản hóa quá mức.
Có phải RAG luôn truy xuất theo từng đoạn nhỏ?
Không nhất thiết.
Trong các hệ thống RAG riêng, tài liệu thường được chia thành chunks để việc tìm kiếm chính xác và tiết kiệm context hơn. Nghiên cứu RAG gốc, chẳng hạn, chia Wikipedia thành các đoạn 100 từ.
Nhưng cách chunk có thể dựa trên:
Số token.
Heading.
Đoạn văn.
Section.
Toàn bộ tài liệu.
Semantic boundary.
Cấu trúc riêng của dữ liệu.
Quan trọng hơn, với Google Search, chủ website không cần cố chia nội dung thành những đoạn siêu nhỏ để “AI dễ retrieval”.
Google chính thức nói không có yêu cầu phải chunk nội dung thành những phần nhỏ cho AI hiểu. Hệ thống của Google có thể hiểu nhiều chủ đề trên cùng một trang và hiển thị phần phù hợp cho người dùng.
Do đó, lời khuyên thực tế là:
Viết từng phần rõ ràng vì điều đó tốt cho người đọc và cấu trúc thông tin, không phải vì có một “độ dài chunk chuẩn GEO”.
Hạn chế của RAG
RAG cải thiện grounding nhưng không biến AI thành hệ thống luôn đúng.
Retrieval có thể chọn sai nguồn
Nếu hệ thống lấy một tài liệu:
Sai chủ đề.
Lỗi thời.
Thiếu bối cảnh.
Kém chất lượng.
Chứa thông tin sai.
thì generation có thể tiếp tục sử dụng chính dữ liệu đó.
Google Cloud nhấn mạnh chất lượng retrieval là phần cực kỳ quan trọng; dữ liệu truy xuất không phù hợp có thể khiến câu trả lời grounded nhưng vẫn sai hoặc lạc chủ đề.
Ví dụ
Người dùng hỏi:
Chi phí SEO cho doanh nghiệp SME năm 2026 khoảng bao nhiêu?
Nhưng retriever chọn:
Bài báo giá năm 2022.
AI có thể diễn đạt trôi chảy nhưng số liệu không còn phù hợp.
Đây là lý do doanh nghiệp cần cập nhật các trang có yếu tố thời gian.
RAG không loại bỏ hoàn toàn hallucination
Dữ liệu tốt không đồng nghĩa mô hình luôn diễn giải chính xác.
AI vẫn có thể:
Ghép hai nguồn không tương thích.
Bỏ qua điều kiện quan trọng.
Đọc sai bảng.
Suy luận quá mức.
Chuyển “có thể” thành “chắc chắn”.
Gắn một kết luận cho sai nguồn.
RAG được xem là biện pháp giúp giảm rủi ro hallucination và tăng grounding, không phải giải pháp bảo đảm phản hồi luôn chính xác. Google Cloud mô tả việc đưa facts vào context là cách giảm thiểu hallucination.
Nguồn gần nghĩa chưa chắc là nguồn tốt nhất
Vector similarity đo mức tương đồng ngữ nghĩa, không tự đánh giá đầy đủ:
Chuyên môn.
Tính chính xác.
Mức độ cập nhật.
Xung đột lợi ích.
Uy tín.
Nguồn gốc số liệu.
Đó là lý do hệ thống thực tế có thể dùng thêm ranking, filtering và reranking.
Google Search còn dựa vào hệ thống xếp hạng và chất lượng cốt lõi trước khi sử dụng trang trong RAG của Search.
Website không thể kiểm soát RAG của nền tảng
Doanh nghiệp không biết chính xác:
Query nào AI tạo ra.
Retriever sử dụng thuật toán gì.
Có vector search hay không.
Trang được chia thế nào.
Có bao nhiêu nguồn được lấy.
Reranker đánh giá ra sao.
Model chọn câu nào để trích.
Vì sao nguồn A được hiển thị nhưng B không.
Không có một công cụ SEO bên ngoài nào đo được toàn bộ các bước này cho Google Search.
Do đó, không nên tin những dịch vụ tuyên bố có thể “tối ưu điểm RAG Google” nếu không có phương pháp và dữ liệu minh bạch.
Doanh nghiệp cần làm gì để nội dung có cơ hội được truy xuất?
Tám việc cần làm để nội dung có cơ hội được RAG truy xuất
Mục tiêu không phải “viết cho RAG”, mà là tạo những trang đủ tốt để hệ thống tìm kiếm có thể khám phá, hiểu và đánh giá là phù hợp.
Tám hạng mục bên dưới được cụ thể hóa thành thao tác biên tập trong bài cách viết nội dung chuẩn GEO. Nội dung đó hướng dẫn cách mở đoạn bằng câu trả lời trực tiếp và bổ sung đủ ngữ cảnh cho từng phần, để đoạn văn giữ nguyên ý nghĩa khi bị tách khỏi trang gốc.
1. Đảm bảo trang được crawl và index
Đây là điều kiện cơ bản nhất.
Google Search cho biết các generative AI features sử dụng nội dung từ Search index. Trang cần được index và đủ điều kiện hiển thị với snippet để có thể xuất hiện trong các trải nghiệm này.
Doanh nghiệp nên kiểm tra:
Hạng mục
Câu hỏi
Robots.txt
Có vô tình chặn Googlebot không?
Meta robots
Trang có noindex ngoài ý muốn không?
Canonical
Google có chọn đúng URL chính không?
Sitemap
URL quan trọng đã được khai báo chưa?
Internal link
Trang có được liên kết từ website không?
Search Console
Trang có trạng thái Indexed không?
Nếu bài chưa được index, việc tối ưu thêm FAQ hoặc “đoạn GEO” chưa phải ưu tiên.
2. Trả lời rõ câu hỏi chính
Nội dung cần giúp người đọc hiểu nhanh:
Khái niệm là gì.
Vấn đề xảy ra khi nào.
Nguyên nhân là gì.
Điều kiện áp dụng.
Cách xử lý.
Ngoại lệ.
Ví dụ chưa rõ:
RAG là một trong những xu hướng công nghệ rất quan trọng trong bối cảnh AI phát triển mạnh.
Ví dụ rõ hơn:
RAG là kỹ thuật cho phép AI lấy dữ liệu bên ngoài làm context trước khi tạo câu trả lời, giúp hệ thống sử dụng thông tin mới mà không cần huấn luyện lại mô hình.
Câu thứ hai cung cấp định nghĩa có chủ thể, cơ chế và lợi ích.
3. Viết các section có mục tiêu rõ
Không cần cố ép mỗi đoạn thành một chunk kỹ thuật. Nhưng mỗi H2 nên giải quyết một câu hỏi cụ thể.
Heading mơ hồ
Heading rõ hơn
Một số vấn đề cần biết
RAG khác mô hình AI thông thường thế nào?
Cách hoạt động
RAG truy xuất dữ liệu theo quy trình nào?
Những điều quan trọng
RAG có loại bỏ hallucination không?
Ứng dụng
RAG ảnh hưởng gì đến GEO?
Cấu trúc tốt giúp người đọc quét nhanh và cũng làm chủ đề của từng section rõ hơn.
Google khuyến nghị nội dung được tổ chức bằng paragraph, section và heading rõ ràng vì đây là cấu trúc dễ theo dõi đối với người đọc.
4. Làm rõ thực thể
Một đoạn như:
Giải pháp này phù hợp với doanh nghiệp trong trường hợp đó.
có thể phụ thuộc quá nhiều vào đoạn trước.
Trong phần quan trọng, nên dùng lại chủ thể khi cần:
Dịch vụ SEO tổng thể phù hợp hơn với doanh nghiệp muốn xây organic traffic dài hạn và có đủ nguồn lực duy trì nội dung.
Không cần lặp tên thương hiệu hoặc từ khóa trong mọi câu, nhưng các thực thể quan trọng phải được dùng nhất quán.
Ví dụ:
DGMASIA.
SEO tổng thể.
Build Team Marketing.
Google Ads.
AI Overview.
Google Search Console.
Không nên gọi cùng một dịch vụ bằng năm tên khác nhau nếu điều đó dễ gây nhầm lẫn.
5. Bổ sung thông tin mà nguồn khác khó sao chép
Google cho biết nội dung có giá trị riêng, góc nhìn thực tế và không phải commodity content có khả năng đóng góp nhiều hơn cho sự hiện diện dài hạn trong generative AI search.
Một bài có thể bổ sung:
Dữ liệu doanh nghiệp tự thu thập.
Case study được phép công bố.
Kinh nghiệm triển khai.
Quy trình riêng.
Hình ảnh thực tế.
Quan điểm chuyên gia.
Ví dụ từ khách hàng.
So sánh dựa trên dữ liệu.
Điều kiện khi phương pháp không phù hợp.
Ví dụ, thay vì chỉ viết:
SEO cần thời gian.
có thể giải thích:
Với website mới, doanh nghiệp nên tách ba mốc: thời gian Google crawl/index nội dung, thời gian từ khóa bắt đầu có impression và thời gian organic traffic tạo đủ lead để đánh giá hiệu quả kinh doanh. Ba mốc này không nhất thiết xảy ra cùng lúc.
Đoạn sau cung cấp mô hình đánh giá cụ thể hơn.
6. Cập nhật phần có yếu tố thời gian
RAG có lợi thế ở khả năng sử dụng dữ liệu mới, nhưng điều đó chỉ có giá trị nếu website vẫn duy trì thông tin chính xác.
Những trang cần rà soát thường xuyên gồm:
Nội dung
Khi nào cần kiểm tra?
Giá
Khi bảng giá thay đổi
Chính sách
Ngay khi có chính sách mới
Tính năng sản phẩm
Khi release
Số liệu
Khi có báo cáo mới
Tài liệu công cụ
Khi nền tảng cập nhật
Bài AI/SEO
Khi Google hoặc nền tảng thay đổi hướng dẫn
Hồ sơ nhân sự
Khi chức danh thay đổi
Không nên đổi ngày cập nhật chỉ để tạo cảm giác mới. Nội dung phải thực sự được rà soát.
7. Dẫn nguồn cho những claim quan trọng
RAG không đồng nghĩa hệ thống tự biết claim nào đáng tin.
Doanh nghiệp nên dẫn về nguồn gốc với:
Số liệu nghiên cứu.
Tài liệu Google.
Quy định.
Thông số kỹ thuật.
Báo cáo ngành.
Tuyên bố từ nền tảng.
Dữ liệu bên thứ ba.
Ví dụ:
“Google sử dụng RAG trong AI Overviews” nên dẫn tài liệu Google Search Central, thay vì dẫn một blog SEO đang diễn giải lại tài liệu đó.
Nguồn cấp một giúp cả người đọc và biên tập viên kiểm chứng thông tin dễ hơn.
8. Xây internal link theo cụm chủ đề
Một bài về RAG có thể liên kết đến:
RAG là gì?
├── Vector Search là gì?
├── GEO là gì?
├── AI Search hoạt động thế nào?
├── Nội dung chuẩn GEO
├── Entity SEO
└── Cách đo traffic từ AI Search
Internal link không phải phương pháp “buộc RAG đi theo link”. Vai trò chính là giúp người đọc và công cụ tìm kiếm khám phá mối quan hệ giữa các nội dung.
Google tiếp tục xem cấu trúc kỹ thuật, khả năng crawl và các thực hành SEO nền tảng là yếu tố cần thiết cho generative AI search.
Những việc không cần làm chỉ để “tối ưu RAG”
Mẹo thường được truyền miệng
Có cần không?
Mỗi đoạn phải đúng 100–150 từ
Không
Mỗi câu phải lặp entity
Không
Tạo một trang cho mọi fan-out query
Không
Viết lại toàn bộ content chỉ dành cho AI
Không
Nhồi từ đồng nghĩa để tăng vector similarity
Không
Chia bài thành càng nhiều đoạn càng tốt
Không
Tạo LLMs.txt để Google AI đọc
Google xác nhận không cần
Bỏ SEO truyền thống và chỉ làm GEO
Không
Google hiện khẳng định không cần chunk content thành phần nhỏ, không cần viết riêng cho AI và không cần tạo các file đặc biệt như LLMs.txt để xuất hiện trong Google Search generative AI features.
Bài học quan trọng là:
RAG giúp giải thích vì sao retrieval quan trọng, nhưng không biến những mẹo định dạng thành yếu tố xếp hạng.
Làm sao biết website đang xuất hiện trong AI Search?
Trước khi theo dõi mức độ xuất hiện, doanh nghiệp cần chắc chắn website đủ điều kiện được truy xuất. Bài GEO audit và cách kiểm tra website sẵn sàng cho AI Search đưa ra quy trình rà soát khả năng crawl, cấu trúc nội dung và tín hiệu thực thể — những điều kiện cần trước khi bàn đến số liệu hiển thị.
Trước đây, doanh nghiệp chủ yếu phải quan sát gián tiếp. Đến tháng 6/2026, Google bắt đầu thử nghiệm Generative AI performance report trong Search Console cho một số website.
Báo cáo có thể cho biết:
Tổng impression trong AI Overviews và AI Mode.
Trang nào nhận nhiều impression.
Quốc gia.
Thiết bị.
Xu hướng theo ngày hoặc khoảng thời gian.
Google hiện vẫn đang rollout báo cáo cho một nhóm website, vì vậy không phải tài khoản Search Console nào cũng nhìn thấy tính năng này.
Dữ liệu này có cho biết hệ thống đã retrieval ra sao không?
Không.
Search Console có thể cho biết một URL được hiển thị trong generative AI features, nhưng không cung cấp:
Vector similarity score.
Chunk nào được retrieval.
Fan-out query đầy đủ.
Reranking score.
Vì sao một trang được chọn.
Nguồn nào cạnh tranh với trang.
Prompt nội bộ.
Do đó, đây là dữ liệu visibility, không phải “RAG debugger”.
Ngoài Google có thể theo dõi thế nào?
Doanh nghiệp có thể kết hợp:
Cách theo dõi
Giá trị
AI referral traffic
Biết lượt truy cập đến từ AI assistant
Server log
Quan sát crawler hoặc request
Manual testing
Xem thương hiệu có xuất hiện ở truy vấn chiến lược
Brand monitoring
Theo dõi mention theo thời gian
CRM
Xác định lead có biết đến doanh nghiệp qua AI hay không
Các phương pháp trên chỉ cung cấp tín hiệu. Không thể kết luận một nền tảng đã sử dụng RAG theo cách cụ thể chỉ từ referral traffic.
RAG khác Semantic Search và Vector Search thế nào?
Ba thuật ngữ này thường bị dùng thay thế cho nhau nhưng khác vai trò.
Khái niệm
Chức năng
Embedding
Chuyển dữ liệu thành vector
Vector Search
Tìm nội dung gần nhau về ngữ nghĩa
Semantic Search
Trải nghiệm tìm kiếm hiểu ý nghĩa truy vấn
Retrieval
Lấy dữ liệu cần thiết từ nguồn
RAG
Đưa dữ liệu truy xuất vào quá trình tạo câu trả lời
Generation
Mô hình tạo phản hồi
Có thể hình dung:
Vector Search
↓
có thể là một cách Retrieval
↓
Retrieval
↓
được dùng trong RAG
↓
LLM tạo câu trả lời
Nhưng:
RAG ≠ Vector Search
Vector Search ≠ RAG
Một hệ thống RAG hoàn toàn có thể dùng keyword search hoặc API thay cho vector search.
Ví dụ thực tế: RAG có thể chọn nội dung như thế nào?
Giả sử người dùng hỏi:
Website có traffic SEO nhưng không tạo lead thì nên kiểm tra gì trước?
DGMASIA có một bài:
SEO lên top nhưng không có khách: Lỗi nằm ở đâu?
Bài được cấu trúc thành:
Search intent.
Nội dung.
Landing page.
Tracking.
Hướng kiểm tra.
Bảng chẩn đoán.
Một hệ thống AI Search có thể retrieval nội dung này vì nó liên quan trực tiếp đến vấn đề.
Trong cùng câu trả lời, hệ thống còn có thể lấy:
Tài liệu Google Analytics về key event.
Tài liệu Search Console.
Một nghiên cứu CRO.
Một trang khác về landing page.
Sau đó AI tổng hợp thành câu trả lời.
Website DGMASIA không cần chứa mọi kiến thức trong một trang. Giá trị nằm ở việc trang cung cấp một phần bằng chứng phù hợp và có giá trị với câu hỏi.
Checklist rà nội dung theo góc nhìn RAG và GEO
Checklist rà nội dung theo góc nhìn RAG và GEO
Tiêu chí
Đạt
Cần sửa
Trang được Google index
☐
☐
Chủ đề chính được nêu rõ ngay đầu bài
☐
☐
Mỗi H2 giải quyết câu hỏi cụ thể
☐
☐
Nội dung đúng search intent
☐
☐
Thực thể và thuật ngữ được dùng nhất quán
☐
☐
Claim quan trọng có nguồn
☐
☐
Có dữ liệu, kinh nghiệm hoặc góc nhìn riêng
☐
☐
Nội dung thời gian đã được cập nhật
☐
☐
Không có nhiều bài trùng intent
☐
☐
Internal link kết nối đúng cụm chủ đề
☐
☐
Nội dung quan trọng tồn tại dưới dạng text
☐
☐
Mobile và page experience ổn định
☐
☐
Không cố “chunk” chỉ để phục vụ AI
☐
☐
Không nhồi biến thể từ khóa
☐
☐
Có theo dõi AI visibility nếu công cụ hỗ trợ
☐
☐
Những hiểu lầm phổ biến về RAG
“Chỉ cần viết từng đoạn thật ngắn là AI sẽ lấy”
Không có quy tắc như vậy. Chunking là quyết định kỹ thuật ở phía hệ thống retrieval. Google xác nhận website không cần chia content thành các phần nhỏ chỉ vì AI Search.
“RAG sẽ chọn trang có vector gần nhất”
Chỉ đúng với một số kiến trúc vector-only đơn giản.
Google AI Search sử dụng core ranking systems cùng RAG, còn nhiều hệ thống doanh nghiệp sử dụng hybrid search, filter và reranker.
“Được retrieval nghĩa là chắc chắn được trích dẫn”
Không. Một nguồn có thể được hệ thống xem xét nhưng không nhất thiết được hiển thị cuối cùng. Quá trình generation và source selection còn có thể loại, gộp hoặc ưu tiên nguồn khác.
“RAG giúp AI không hallucinate”
RAG giảm rủi ro bằng cách bổ sung dữ liệu có cơ sở nhưng không loại bỏ hoàn toàn hallucination.
“SEO không còn quan trọng vì AI dùng RAG”
Ngược lại, với Google Search, RAG dựa vào chính Search index và core Search ranking systems để retrieval web pages. Google nói rõ SEO nền tảng vẫn phù hợp với generative AI search.
Khi nào doanh nghiệp cần quan tâm đến RAG?
Doanh nghiệp không cần biết cách lập trình vector database để làm content. Nhưng hiểu nguyên lý RAG có ích khi:
Tình trạng
Vì sao nên hiểu RAG?
Muốn xuất hiện trong AI Overviews/AI Mode
Hiểu vai trò của retrieval và Search index
Content nhiều nhưng ít AI visibility
Biết cần audit cả index, relevance và quality
Website có dữ liệu chuyên môn
Biết giá trị của thông tin gốc và cập nhật
Đang làm GEO
Tránh chạy theo các mẹo “AI optimization” không có căn cứ
Có chatbot nội bộ
Hiểu cách dữ liệu được retrieval trước khi trả lời
Muốn xây knowledge base
Hiểu vai trò của cấu trúc dữ liệu và nguồn
Người làm marketing không cần biết thuật toán Maximum Inner Product Search hay cấu hình vector database. Điều cần hiểu là:
AI không nhất thiết phải “nhớ” doanh nghiệp từ dữ liệu huấn luyện. Một hệ thống có retrieval có thể tìm thông tin doanh nghiệp tại thời điểm người dùng đặt câu hỏi.
Kết luận
RAG là kỹ thuật kết hợp quá trình truy xuất thông tin bên ngoài với khả năng tạo ngôn ngữ của LLM. Thay vì chỉ dựa vào những gì mô hình đã học trong quá trình huấn luyện, hệ thống có thể tìm thêm website, tài liệu, database hoặc nguồn dữ liệu khác rồi dùng chúng làm context trước khi tạo phản hồi.
RAG được giới thiệu rộng rãi qua nghiên cứu của Patrick Lewis và cộng sự năm 2020. Từ đó, kỹ thuật này trở thành nền tảng quan trọng trong nhiều hệ thống AI có khả năng truy xuất dữ liệu bên ngoài.
Với Google Search, RAG không còn là suy đoán. Google hiện công bố AI Overviews và AI Mode sử dụng RAG/grounding kết hợp với core Search ranking systems để truy xuất những trang web liên quan, cập nhật và dùng thông tin từ chúng để tạo phản hồi.
Điều này không có nghĩa doanh nghiệp cần “tối ưu RAG” bằng các mẹo như chia mọi đoạn thành chunk, tạo hàng loạt trang theo fan-out query hoặc nhồi từ đồng nghĩa. Google khuyến nghị tiếp tục tập trung vào nội dung hữu ích, có giá trị riêng, cấu trúc rõ, có thể crawl/index và phục vụ tốt người dùng.
Doanh nghiệp không kiểm soát cách AI Search triển khai retrieval. Phần có thể kiểm soát là chất lượng nguồn: nội dung có chính xác không, trang có được index không, chủ đề có rõ không, bằng chứng có đủ không và thông tin có còn cập nhật không.
Nếu website đã có nhiều bài nhưng vẫn ít xuất hiện trong AI Search, bước tiếp theo nên là audit toàn bộ quá trình từ crawl/index, search intent, content quality, entity, internal link đến AI visibility thay vì chỉ sửa câu chữ theo một công thức GEO.
DGMASIA có thể hỗ trợ doanh nghiệp rà soát cấu trúc website, search intent, topic cluster, chất lượng content và mức độ sẵn sàng cho Google Search generative AI features. Mục tiêu không phải “lách RAG”, mà là xây một website có nội dung đủ rõ, đủ tin cậy và đủ giá trị để trở thành nguồn tham khảo khi người dùng tìm kiếm.
RAG có phải công nghệ mới xuất hiện gần đây không?
Không. RAG được giới thiệu rộng rãi qua nghiên cứu của Patrick Lewis và cộng sự năm 2020. Kỹ thuật này trở nên được quan tâm mạnh hơn khi chatbot có tìm kiếm web và AI Search phát triển.
Làm sao biết nội dung đang xuất hiện trong AI Search?
Với Google, một số website hiện đã có Generative AI performance report trong Search Console để xem impression từ AI Overviews và AI Mode. Báo cáo vẫn đang được rollout nên chưa phải tài khoản nào cũng có. Với các nền tảng khác, doanh nghiệp thường phải kết hợp referral traffic và kiểm tra truy vấn thực tế.
RAG có giống SEO truyền thống không?
Không. RAG là kiến trúc kết hợp retrieval và generation, còn SEO là quá trình giúp website được crawl, index, hiểu, xếp hạng và phục vụ người tìm kiếm. Tuy nhiên, với Google AI Search, hai phần có liên hệ chặt vì RAG sử dụng core Search ranking systems và Search index để lấy nguồn.
Có cần công cụ kỹ thuật để tối ưu nội dung cho RAG không?
Không bắt buộc với phần lớn doanh nghiệp. Quan trọng hơn là website được index, nội dung rõ ràng, đúng intent, có nguồn và giá trị thực tế. Không có công cụ phổ biến nào cho doanh nghiệp biết trực tiếp “điểm RAG” của một URL trong Google Search.
RAG có loại bỏ hoàn toàn tình trạng AI trả lời sai không?
Không. RAG giúp bổ sung thông tin liên quan và giảm rủi ro hallucination, nhưng retrieval có thể lấy sai nguồn hoặc mô hình có thể diễn giải sai thông tin. Những quyết định quan trọng vẫn cần kiểm tra nguồn gốc.
Doanh nghiệp nhỏ có cần quan tâm đến RAG không?
Có, nhưng chỉ cần hiểu ở mức nguyên lý. Doanh nghiệp không cần tự xây vector database để làm SEO/GEO; điều cần quan tâm là làm cho website có nội dung chính xác, dễ khám phá, đúng nhu cầu và có giá trị đủ để trở thành nguồn tham khảo.