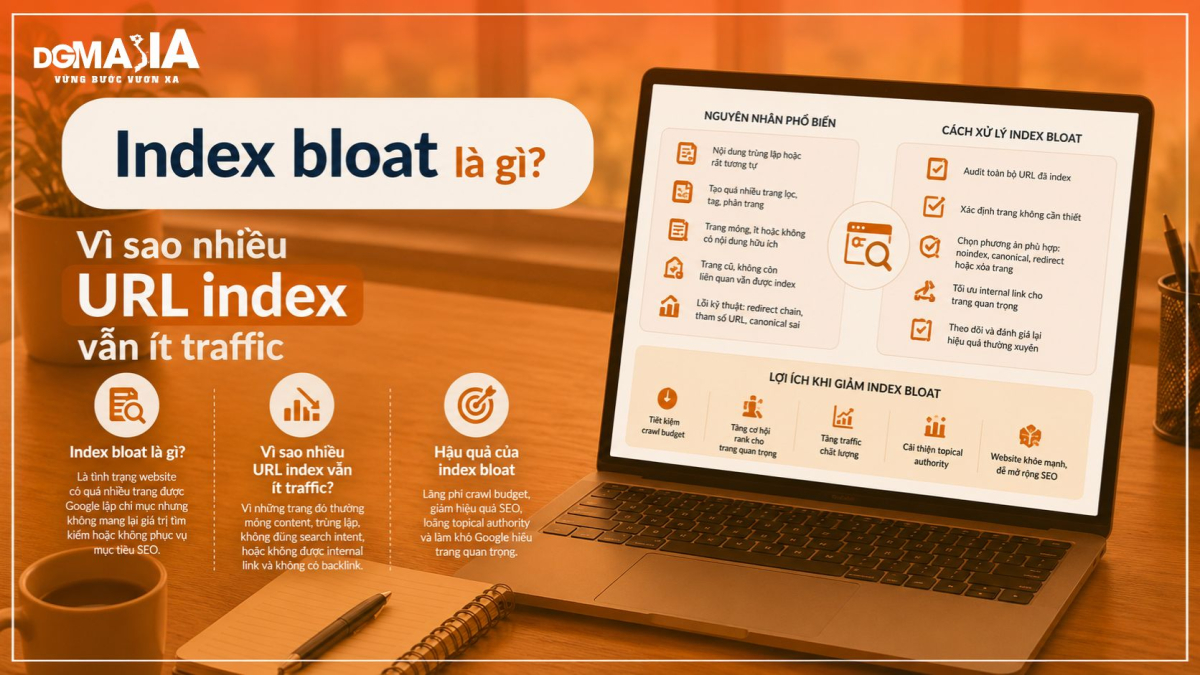
Index bloat là tình trạng Google index quá nhiều URL ít giá trị trên website, khiến số trang được lập chỉ mục tăng nhưng traffic SEO không tăng tương ứng. Vấn đề không nằm ở việc website có nhiều trang, mà nằm ở việc quá nhiều trang được index nhưng không phục vụ mục tiêu tìm kiếm, không có nội dung đủ khác biệt hoặc không liên quan đến các trang cần xếp hạng.
Nhiều doanh nghiệp nhìn thấy Google Search Console báo hàng nghìn URL được index và nghĩ đó là tín hiệu tốt. Nhưng nếu phần lớn số URL đó là trang lọc sản phẩm, trang tìm kiếm nội bộ, trang phân trang, trang tag, trang lưu trữ, URL có tham số hoặc bài viết mỏng, chúng có thể làm loãng tín hiệu SEO thay vì hỗ trợ tăng trưởng organic traffic.
Vì vậy, khi website có nhiều URL index nhưng traffic vẫn thấp, câu hỏi cần đặt ra không phải là “làm sao để index thêm nhiều trang”, mà là “những trang đang được index có thật sự đáng được Google đưa vào kết quả tìm kiếm hay không”. Bài viết dưới đây sẽ giúp doanh nghiệp hiểu rõ Index bloat là gì, nguyên nhân thường gặp, cách kiểm tra bằng Google Search Console và cách xử lý an toàn mà không chặn nhầm các trang quan trọng.
Index bloat là gì?
Nhiều chủ doanh nghiệp thấy Google Search Console báo hàng nghìn trang được index và nghĩ đó là dấu hiệu tốt, trong khi phần lớn số đó có thể đang âm thầm làm loãng tín hiệu SEO của website.
Index bloat là tình trạng Google lập chỉ mục quá nhiều URL ít hoặc không có giá trị trên một website. Những URL này có thể vẫn tồn tại thật, vẫn crawl được, thậm chí vẫn được index, nhưng không đóng góp nhiều cho traffic, chuyển đổi hoặc topical authority của website.
Ví dụ thường gặp:
Trang lọc sản phẩm theo màu sắc, size, giá, thương hiệu.
URL có tham số như ?sort=price-asc, ?color=black, ?utm_source=….
Trang tìm kiếm nội bộ.
Trang tag quá mỏng.
Trang lưu trữ theo ngày/tháng.
Trang phân trang không cần index.
Trang sản phẩm hết hàng nhưng không có nội dung thay thế.
Bài viết quá ngắn hoặc tự động sinh.
Các URL trùng lặp do HTTP/HTTPS, www/non-www, slash/non-slash.
Trang category có nhiều biến thể nhưng nội dung gần như giống nhau.
Có nhiều trang được index không đồng nghĩa với nhiều cơ hội xếp hạng. Nếu phần lớn URL được index là nội dung trùng lặp, thin content hoặc không liên quan, chúng có thể khiến Google khó hiểu trang nào mới là trang chính, trang nào nên được ưu tiên và chủ đề nào thật sự quan trọng trên website.
Index bloat là gì
Dấu hiệu dễ thấy nhất của Index bloat là số trang được index cao hơn nhiều so với số trang doanh nghiệp thật sự muốn xếp hạng. Ví dụ, doanh nghiệp chỉ có 80 trang sản phẩm/dịch vụ/bài viết quan trọng, nhưng Google lại index 5.000 URL vì hệ thống lọc, tag, phân trang hoặc tham số tạo ra nhiều biến thể.
Google Search Console Help cho biết Page Indexing report hiển thị số trang Google đã cố gắng crawl và liệu các trang đó có được index hay không. Báo cáo này giúp chủ website có cái nhìn tổng quan về mức độ bao phủ của website trên Google Search.
Vì vậy, khi kiểm tra index, doanh nghiệp không nên chỉ hỏi “Google đã index bao nhiêu URL”, mà phải hỏi “trong số URL đó, bao nhiêu trang thật sự có giá trị SEO và kinh doanh?”.
Vì sao nhiều URL index nhưng traffic không tăng?
Website có hàng nghìn trang được index nhưng traffic không tăng không phải lúc nào cũng vì thiếu nội dung. Nhiều trường hợp, vấn đề nằm ở việc phần lớn URL được index đang cạnh tranh ngược lại với chính các trang quan trọng nhất.
Có ba nguyên nhân chính.
Crawl budget bị dùng sai chỗ
Mỗi lần Google crawl một URL, hệ thống cần dùng tài nguyên để truy cập, tải và xử lý trang đó. Với website nhỏ, crawl budget thường không phải vấn đề quá lớn. Nhưng với website vừa/lớn, đặc biệt là ecommerce, marketplace, website có bộ lọc hoặc website có nhiều URL động, việc Google crawl quá nhiều URL ít giá trị có thể làm các trang quan trọng được crawl và cập nhật chậm hơn.
Google Crawling Infrastructure hướng dẫn rằng chủ website nên quản lý URL inventory. Nếu Google dành quá nhiều thời gian crawl những URL không nên crawl, crawler có thể quyết định không đáng để xem phần còn lại của site hoặc tăng ngân sách crawl cho site.
Điều này không có nghĩa mọi website có nhiều URL đều gặp vấn đề. Nhưng nếu Crawl Stats tăng mạnh, trong khi traffic và số trang quan trọng được index không tăng tương ứng, doanh nghiệp nên kiểm tra xem Googlebot đang tiêu thời gian vào nhóm URL nào.
Vì sao nhiều URL index nhưng traffic không tăng
Nhiều trang tương tự cạnh tranh lẫn nhau
Khi website có nhiều URL gần giống nhau, Google phải chọn URL nào là phiên bản đại diện. Nếu website không chỉ rõ canonical hoặc internal link trỏ lung tung giữa nhiều biến thể, tín hiệu SEO có thể bị phân tán.
Ví dụ, một category “giày chạy bộ nam” có thể tạo ra nhiều URL:
/giay-chay-bo-nam/
/giay-chay-bo-nam/?sort=price-asc
/giay-chay-bo-nam/?color=black
/giay-chay-bo-nam/?brand=nike
/giay-chay-bo-nam/?size=42&color=black
Nếu các URL này được index riêng nhưng nội dung gần như giống nhau, Google có thể mất thêm thời gian để hiểu đâu là trang chính. Về mặt SEO, các biến thể này không làm website mạnh hơn nếu chúng không có intent tìm kiếm riêng.
Google Search Central giải thích canonical giúp chỉ định URL ưu tiên cho các trang trùng lặp hoặc rất giống nhau, đồng thời giúp hợp nhất tín hiệu của các URL tương tự và tránh việc Googlebot dành thời gian crawl các phiên bản trùng lặp thay vì trang mới hoặc trang được cập nhật.
Nội dung chất lượng thấp làm loãng hệ thống nội dung
Nhiều URL index nhưng ít traffic còn có thể đến từ nội dung mỏng. Một website có nhiều bài tự động sinh, trang tag rỗng, trang archive ít giá trị hoặc trang sản phẩm chỉ có tên và ảnh nhưng không có mô tả riêng sẽ khó tạo tín hiệu chất lượng rõ.
Không nên hiểu máy móc rằng “một vài trang yếu sẽ làm cả website bị phạt”. Nhưng nếu tỷ lệ URL ít giá trị quá lớn, website sẽ khó xây topical authority rõ ràng. Google có tài liệu về nội dung hữu ích, trong đó khuyến nghị nội dung nên được tạo để phục vụ người đọc, có giá trị thực tế, đáng tin và không chỉ nhằm mục tiêu thao túng thứ hạng.
Với SEO chuyển đổi, vấn đề còn rõ hơn. Nếu Google index nhiều URL nhưng các URL đó không kéo đúng người đọc, không dẫn về trang dịch vụ, không có CTA và không nằm trong một cụm chủ đề có chiến lược, traffic khó tăng và lead càng khó tăng.
Chất lượng nội dung yếu ở quy mô lớn là một trong những nguyên nhân rớt hạng từ khóa website phổ biến nhất — đáng đọc thêm nếu website đang có index cao nhưng thứ hạng từ khóa lại giảm dần.
Nguyên nhân phổ biến gây ra index bloat
Phần lớn nguyên nhân Index bloat không đến từ nội dung cố ý viết sai, mà từ những URL kỹ thuật được tạo ra ngoài tầm kiểm soát của đội content.
URL động và tham số
Đây là nguyên nhân phổ biến nhất ở website ecommerce, website có bộ lọc sản phẩm, website có chức năng tìm kiếm nội bộ hoặc website dùng nhiều tham số để sắp xếp/lọc nội dung.
Một sản phẩm hoặc danh mục có thể sinh ra rất nhiều URL khác nhau chỉ vì người dùng lọc theo:
Giá.
Màu sắc.
Size.
Thương hiệu.
Tình trạng còn hàng.
Đánh giá.
Khu vực.
Sắp xếp theo mới nhất/bán chạy/giá tăng dần.
Tham số tracking.
Với người dùng, filter rất hữu ích. Nhưng với SEO, không phải mọi URL filter đều cần index.
Nguyên nhân phổ biến gây ra index bloat
Google có tài liệu riêng về faceted navigation, trong đó nêu rằng crawl các faceted URL có thể tiêu tốn nhiều tài nguyên do số lượng URL và thao tác render lớn. Google cũng khuyến nghị nếu không cần các URL này xuất hiện trên Google Search, có thể ngăn crawling bằng robots.txt hoặc dùng URL fragments cho filter trong một số trường hợp.
Ví dụ:
Nhóm URL
Có nên index không?
Lưu ý
Category chính
Nên
Đây thường là trang SEO chính
Sub-category có nhu cầu tìm kiếm rõ
Có thể
Cần nội dung riêng và intent riêng
Filter theo màu/size quá nhỏ
Thường không
Dễ tạo nhiều URL gần giống nhau
Sort theo giá/mới nhất/bán chạy
Thường không
Chỉ đổi thứ tự, không đổi intent
Trang tìm kiếm nội bộ
Thường không
Dễ mỏng, biến động, ít giá trị SEO
URL tracking/UTM
Không
Nên canonical về URL sạch
Nội dung mỏng hoặc tự động sinh
Index bloat cũng có thể đến từ thin content. Không phải bài nào ngắn cũng xấu, nhưng nếu một URL không có thông tin đủ khác biệt, không giải quyết được nhu cầu tìm kiếm và không có lý do để tồn tại riêng, nó có nguy cơ trở thành trang ít giá trị.
Ví dụ:
Trang sản phẩm chỉ có tên sản phẩm và ảnh.
Trang dịch vụ theo khu vực chỉ đổi tên thành phố.
Trang tag chỉ có vài bài nhưng không có mô tả.
Trang archive theo ngày/tháng không có mục đích tìm kiếm.
Trang tự động sinh từ database nhưng thiếu dữ liệu riêng.
Trang programmatic SEO chỉ thay biến số trong cùng một mẫu.
Với những website làm Programmatic SEO, rủi ro này càng cao. Nếu dữ liệu không đủ khác biệt, mỗi trang mới không thêm giá trị thật mà chỉ tăng số URL.
Đây chính là biểu hiện cụ thể của thin content và cách khắc phục ở quy mô lớn — đáng tham khảo để phân biệt trang nên noindex hẳn với trang chỉ cần bổ sung nội dung.
Thiếu canonical hoặc cấu hình sai
Canonical giúp Google hiểu phiên bản chính của các trang trùng lặp hoặc rất giống nhau. Nếu thiếu canonical, canonical trỏ sai, hoặc internal link lại trỏ về các URL biến thể, Google có thể tự chọn canonical khác với mong muốn của doanh nghiệp.
Google cho biết nếu chủ website không chỉ định canonical, Google sẽ tự xác định phiên bản tốt nhất để hiển thị trong Search. Tuy nhiên, việc chỉ định canonical rõ ràng có thể giúp hợp nhất tín hiệu, đơn giản hóa đo lường và tránh lãng phí thời gian crawl vào các phiên bản trùng lặp.
Các lỗi thường gặp:
Lỗi canonical
Rủi ro
Không có canonical trên URL biến thể
Google tự chọn, có thể không đúng URL mong muốn
Canonical trỏ về URL không liên quan
Tín hiệu sai, trang chính khó được hiểu đúng
Canonical dùng URL tương đối
Dễ phát sinh lỗi khi môi trường staging/test bị crawl
Sitemap chứa URL không canonical
Gửi tín hiệu mâu thuẫn cho Google
Internal link trỏ về URL có tham số
Củng cố sai phiên bản URL
Dùng robots.txt, noindex hoặc sitemap sai cách
Robots.txt và noindex không giống nhau. Đây là phần nhiều website xử lý nhầm.
Robots.txt dùng để chặn crawler request một URL hoặc nhóm URL. Noindex là chỉ thị ở cấp trang hoặc HTTP header để yêu cầu công cụ tìm kiếm không index nội dung đó. Google Search Central lưu ý nếu một trang bị chặn crawling bằng robots.txt, Googlebot sẽ không thấy được noindex trong trang, nên chỉ thị noindex có thể không được phát hiện.
Google cũng lưu ý một URL bị disallow trong robots.txt vẫn có thể được index nếu được liên kết từ nơi khác, dù Google không crawl và index nội dung bị chặn.
Vì vậy, nếu muốn loại một trang khỏi index, không nên chỉ chặn robots.txt khi Google chưa đọc được noindex. Ngược lại, nếu muốn tiết kiệm crawl với các faceted URL không cần search, robots.txt có thể phù hợp hơn trong một số trường hợp sau khi đã chắc chắn không cần Google crawl nhóm URL đó.
Việc dùng đúng robots.txt cho từng nhóm URL được trình bày chi tiết hơn trong robots.txt là gì và cách tối ưu — đáng tham khảo trước khi chặn crawl hàng loạt nhóm URL faceted navigation.
Cách xác định website có đang bị index bloat không
Dấu hiệu rõ nhất của Index bloat không phải là ít trang được index, mà là crawl stats tăng đều trong khi traffic và số trang thực sự hữu ích gần như đứng yên.
Doanh nghiệp có thể kiểm tra theo bốn bước.
Bước 1: So sánh số trang muốn index và số trang thực tế được index
Hãy lập một con số ước lượng:
Website có bao nhiêu trang dịch vụ quan trọng?
Bao nhiêu category/sub-category thật sự cần rank?
Bao nhiêu bài blog chất lượng?
Bao nhiêu trang sản phẩm còn hoạt động?
Bao nhiêu trang khu vực thật sự có nội dung riêng?
Bao nhiêu landing page cần xuất hiện trên Google?
Sau đó so với số URL indexed trong Google Search Console.
Ví dụ:
Nhóm trang
Số URL doanh nghiệp muốn index
Số URL thực tế Google index
Trang dịch vụ
20
20
Bài blog chất lượng
150
150
Category/sub-category
80
80
Sản phẩm còn hoạt động
700
700
URL filter/tag/archive/search
0–50
8.000
Tổng kỳ vọng
Khoảng 950
8.950
Nếu phần chênh lệch lớn nằm ở filter, tag, archive, search hoặc URL tham số, website có nguy cơ Index bloat.
Bước 2: Kiểm tra Page Indexing trong Search Console
Trong Search Console, vào mục Page Indexing để xem các nhóm URL indexed và not indexed. Google Help cho biết report này hiển thị số trang Google đã cố gắng crawl và trạng thái index; với site lớn hơn khoảng 500 trang, chủ website nên cân nhắc dùng Page Indexing report để theo dõi.
Các nhóm cần chú ý:
Indexed, though blocked by robots.txt.
Alternate page with proper canonical tag.
Duplicate without user-selected canonical.
Crawled – currently not indexed.
Discovered – currently not indexed.
Soft 404.
Excluded by noindex tag.
Không phải trạng thái nào cũng là lỗi. Ví dụ, “Alternate page with proper canonical tag” có thể là điều bình thường nếu canonical được cấu hình đúng. Nhưng nếu số lượng quá lớn hoặc URL mẫu lặp lại bất thường, cần kiểm tra xem hệ thống có đang tạo quá nhiều URL dư thừa không.
Bước 3: Kiểm tra mẫu URL gây nhiễu
Không nên đọc từng URL thủ công nếu website có nhiều nghìn trang. Hãy nhóm theo mẫu:
Mẫu URL
Khả năng gây Index bloat
?sort=
Cao
?filter=
Cao
?color= / ?size= / ?price=
Cao
/tag/
Tùy chất lượng tag
/search/ hoặc ?s=
Cao
/page/2/, /page/3/
Tùy cấu trúc phân trang
/date/2024/05/
Thường thấp giá trị SEO
URL UTM
Không nên index
URL session ID
Không nên index
Nếu các mẫu URL này chiếm tỷ lệ lớn trong index, doanh nghiệp nên audit kỹ.
Bước 4: Xem Crawl Stats và traffic
Search Console Crawl Stats report hiển thị thống kê lịch sử Google crawl website, bao gồm số request, phản hồi và vấn đề liên quan đến crawling.
Nếu crawl request tăng nhưng organic traffic không tăng, không nên kết luận ngay là Index bloat. Nhưng đây là tín hiệu để kiểm tra Googlebot đang crawl loại URL nào.
Một dấu hiệu đáng chú ý là:
Google crawl nhiều URL tham số/filter.
Trang quan trọng lâu cập nhật trên index.
Nhiều URL “Crawled – currently not indexed”.
Sitemap chỉ có vài trăm URL chính, nhưng Google phát hiện hàng nghìn URL ngoài sitemap.
Traffic tập trung ở ít trang, trong khi index phình to.
Trong trường hợp này, vấn đề không phải là “Google không index đủ”, mà có thể là Google đang thấy quá nhiều URL không đủ giá trị.
Cách khắc phục index bloat
Khắc phục Index bloat không phải là xóa bớt trang cho gọn, mà là hướng crawl budget và tín hiệu SEO tập trung đúng vào những trang thực sự cần xếp hạng.
Không nên xử lý toàn bộ cùng lúc. Hãy bắt đầu bằng phân nhóm URL, xác định mục đích của từng nhóm và chọn công cụ phù hợp: canonical, noindex, robots.txt, redirect, 404/410, cập nhật sitemap hoặc cải thiện internal link.
Cách khắc phục index bloat
Noindex và canonical cho trang trùng lặp
Noindex phù hợp khi trang không cần xuất hiện trên kết quả tìm kiếm nhưng vẫn cần để người dùng sử dụng hoặc cần Google crawl để đọc chỉ thị.
Ví dụ:
Trang tìm kiếm nội bộ.
Một số trang lọc không có giá trị SEO.
Trang tag mỏng nhưng vẫn cần người dùng truy cập trong site.
Trang tài khoản/người dùng không cần xuất hiện trên Search.
Google Search Central cho biết noindex có thể được đặt bằng meta tag hoặc HTTP response header để ngăn nội dung được index bởi công cụ tìm kiếm hỗ trợ noindex.
Canonical phù hợp khi có nhiều URL rất giống nhau nhưng doanh nghiệp muốn giữ một URL chính.
Ví dụ:
URL có UTM.
URL sort sản phẩm.
URL filter nhẹ nhưng vẫn gần giống category chính.
Trang có nhiều đường dẫn truy cập nhưng cùng nội dung.
Cách chọn nhanh:
Tình huống
Công cụ nên ưu tiên
Trang trùng hoặc gần giống, có URL chính thay thế
Canonical
Trang không cần xuất hiện trên Search nhưng vẫn cần người dùng truy cập
Noindex
Trang trùng lặp đã bỏ hẳn và có trang thay thế
301 redirect
Trang không còn tồn tại, không có thay thế
404/410
Nhóm URL filter không cần crawl, tạo quá nhiều biến thể
Robots.txt sau khi cân nhắc kỹ
Gộp nội dung và củng cố internal link
Nếu Index bloat đến từ nhiều bài blog hoặc landing page trùng intent, giải pháp không phải chỉ noindex. Trong nhiều trường hợp, nên gộp nội dung và redirect về một trang mạnh hơn.
Ví dụ, website có 5 bài:
SEO audit là gì?
Audit SEO website gồm những gì?
Checklist audit SEO.
Khi nào nên audit SEO?
Audit SEO technical và content khác nhau thế nào?
Nếu các bài này đều mỏng, trùng lặp và không bài nào rank tốt, doanh nghiệp có thể gộp thành một bài pillar mạnh hơn, sau đó redirect các bài cũ về bài chính.
Sau khi gộp, cần cập nhật internal link. Google Search Central khuyến nghị khi linking nội bộ, nên link đến canonical URL thay vì URL trùng lặp, vì điều này giúp Google hiểu phiên bản doanh nghiệp ưu tiên.
Internal link là phần nhiều doanh nghiệp bỏ qua. Nếu sitemap và canonical nói một hướng, nhưng internal link lại trỏ về hàng nghìn URL tham số, tín hiệu gửi cho Google sẽ bị nhiễu.
Chặn crawl bằng robots.txt khi cần thiết
Robots.txt nên dùng cẩn thận. Nó phù hợp khi doanh nghiệp muốn ngăn Google crawl một nhóm URL không cần thiết, đặc biệt là nhóm URL có thể sinh vô hạn như filter/facet.
Google khuyến nghị với faceted navigation, nếu không cần các URL này xuất hiện trên Google Search hoặc sản phẩm khác của Google, có thể dùng robots.txt để disallow crawling.
Tuy nhiên, không nên dùng robots.txt như một cách thay thế canonical hoặc noindex trong mọi trường hợp. Nếu Google không crawl được URL, Google cũng không đọc được canonical hoặc noindex trên URL đó. Vì vậy, với các URL đã index và cần loại khỏi kết quả, cần chọn trình tự xử lý cẩn thận.
Một cách an toàn hơn là xử lý theo nhóm nhỏ:
Phân loại mẫu URL gây bloat.
Kiểm tra URL đó có traffic/backlink/internal link không.
Xác định URL chính nếu có.
Dùng canonical/noindex/redirect phù hợp.
Chỉ dùng robots.txt cho nhóm URL không cần Google crawl.
Theo dõi Page Indexing và Crawl Stats sau mỗi đợt.
Cập nhật sitemap và trang quan trọng
Sitemap không trực tiếp “xóa” Index bloat, nhưng giúp gửi tín hiệu về những trang doanh nghiệp xem là quan trọng. Google Search Central cho biết sitemap là cách báo cho Google về các trang mới hoặc đã cập nhật, và trong tài liệu canonical, Google cũng nói sitemap là cách đơn giản để khai báo các URL canonical ưu tiên trên site lớn.
Sitemap nên chỉ chứa các URL muốn index:
Trang dịch vụ.
Category/sub-category chính.
Sản phẩm còn hoạt động.
Bài blog chất lượng.
Trang khu vực có nội dung riêng.
Landing page cần SEO.
Không nên đưa URL filter, URL sort, URL UTM, trang tìm kiếm nội bộ hoặc URL không canonical vào sitemap.
Với các trang được giữ lại trong sitemap, cách kiểm tra website đã sẵn sàng cho AI Search chưa là bước nên làm song song — dọn sạch index chỉ có ý nghĩa nếu các trang còn lại thật sự đủ chất lượng để cạnh tranh.
Lỗi thường gặp khi xử lý index bloat
Sai lầm phổ biến nhất không phải là chưa xử lý Index bloat, mà là xử lý vội bằng noindex hoặc robots.txt hàng loạt mà không kiểm tra kỹ nhóm URL nào thực sự cần loại bỏ.
Lỗi đầu tiên là dùng noindex nhầm cho trang quan trọng. Nếu cấu hình noindex theo mẫu URL quá rộng, doanh nghiệp có thể vô tình loại cả category, product page hoặc bài blog có giá trị khỏi kết quả tìm kiếm. Vì vậy, trước khi áp dụng theo rule, cần test trên một nhóm nhỏ.
Lỗi thứ hai là chặn robots.txt sai cách. Nếu chặn một nhóm URL trước khi Google đọc được canonical hoặc noindex, các URL đó có thể vẫn xuất hiện theo dạng “indexed, though blocked by robots.txt” hoặc Google không có đủ dữ liệu để hợp nhất tín hiệu. Google cũng lưu ý robots.txt không nên dùng cho mục đích canonicalization; URL bị robots.txt disallow vẫn có thể được index mà không có nội dung nếu được liên kết từ nơi khác.
Lỗi thứ ba là redirect hàng loạt về trang chủ. Nếu URL cũ không còn dùng nhưng có trang liên quan gần hơn, hãy redirect về trang gần nhất về mặt nội dung. Redirect tất cả về trang chủ thường không giúp người dùng và có thể làm tín hiệu chủ đề bị mất.
Lỗi thứ tư là xử lý toàn bộ cùng lúc. Nếu một website ecommerce có 50.000 URL filter bị index, không nên áp dụng rule lớn ngay mà không theo dõi. Hãy xử lý theo nhóm: sort trước, filter màu/size sau, tag mỏng sau, rồi mới đến các nhóm phức tạp hơn.
Lỗi thứ năm là chỉ xử lý index mà không cải thiện nội dung chính. Nếu category chính vẫn mỏng, trang dịch vụ vẫn thiếu nội dung, internal link vẫn yếu, việc loại bớt URL rác chỉ giải quyết một phần vấn đề. Sau khi dọn bloat, doanh nghiệp vẫn cần củng cố các trang quan trọng.
Nhiều lỗi trong nhóm này, nếu không được xử lý kịp thời, có thể trở thành dấu hiệu website bị Google phạt — đáng đọc thêm để nhận biết sớm trước khi ảnh hưởng lan rộng ra toàn site.
Lỗi thường gặp khi xử lý index bloat
Ví dụ minh họa: một website thương mại điện tử từng để Google index hàng chục nghìn trang lọc sản phẩm theo màu sắc, size và giá. Crawl Stats tăng đều nhưng nhiều category chính cập nhật chậm, trong khi traffic không tăng tương ứng. Sau khi phân nhóm URL, noindex một số trang lọc không có giá trị SEO, dùng robots.txt cho nhóm tham số không cần crawl và củng cố internal link về category chính, hệ thống bắt đầu tập trung tín hiệu tốt hơn vào các trang quan trọng. Đây là tình huống thường gặp khi audit technical SEO, không phải case thật của một khách hàng cụ thể.
Checklist audit Index bloat
Doanh nghiệp có thể dùng checklist sau để kiểm tra nhanh website:
Câu hỏi kiểm tra
Dấu hiệu cần chú ý
Hướng xử lý
Số URL index có cao bất thường không?
Indexed pages cao hơn nhiều so với số trang SEO thật
So sánh sitemap với Page Indexing
Có nhiều URL tham số được index không?
?sort=, ?filter=, ?color=, ?size=
Canonical/noindex/robots tùy nhóm
Trang tìm kiếm nội bộ có index không?
URL /search/ hoặc ?s= xuất hiện trên Google
Thường nên noindex
Tag/archive có traffic không?
Nhiều tag mỏng, không có mô tả
Noindex, gộp hoặc cải thiện
Có nhiều trang duplicate không?
GSC báo duplicate/canonical không như mong muốn
Chỉnh canonical và internal link
Sitemap có chứa URL không canonical không?
Sitemap lẫn filter/sort/UTM
Làm sạch sitemap
Internal link có trỏ nhầm URL tham số không?
Menu/filter/link nội bộ dùng URL biến thể
Link về canonical URL
Crawl Stats tăng nhưng traffic đứng yên?
Googlebot crawl nhiều URL ít giá trị
Kiểm tra mẫu URL được crawl
Có rule noindex/robots quá rộng không?
Trang quan trọng biến mất khỏi Search
Test rule và rollback nếu cần
Trang quan trọng có đủ nội dung chưa?
Category/dịch vụ mỏng dù đã dọn bloat
Củng cố nội dung và internal link
Checklist này nên được xử lý theo từng nhóm URL, không phải theo từng URL rời rạc. Với website lớn, nhóm URL mới là đơn vị audit hiệu quả.
Khi nào nên tự xử lý, khi nào cần chuyên gia technical SEO?
Doanh nghiệp có thể tự kiểm tra Index bloat ở mức cơ bản nếu website nhỏ, ít URL và không có nhiều filter phức tạp. Ví dụ, website dịch vụ có vài chục bài blog, vài trang dịch vụ và một số trang tag có thể bắt đầu bằng Search Console, sitemap và kiểm tra site: trên Google ở mức tham khảo.
Doanh nghiệp có thể tự làm khi:
Website dưới vài trăm URL.
Không có hệ thống filter/phân trang phức tạp.
Có quyền chỉnh sitemap, noindex, canonical cơ bản.
Biết đọc Page Indexing trong Search Console.
Có thể xử lý từng nhóm nhỏ và theo dõi kết quả.
Ngược lại, nên cần chuyên gia technical SEO khi:
Website có hàng nghìn đến hàng chục nghìn URL.
Ecommerce có nhiều bộ lọc/facet.
Search Console báo nhiều nhóm duplicate hoặc canonical lạ.
Traffic không tăng dù số URL index tăng đều.
Google crawl nhiều URL tham số.
Không chắc nên dùng noindex, canonical, redirect hay robots.txt.
Website từng bị chặn nhầm hoặc mất index sau khi chỉnh kỹ thuật.
Cần audit log/crawl, sitemap, canonical và internal link ở quy mô lớn.
Rủi ro lớn nhất khi tự xử lý là dùng sai công cụ đúng vào nhóm URL quan trọng. Một rule robots.txt hoặc noindex sai có thể làm mất khả năng hiển thị của nhiều trang có giá trị. Vì vậy, nếu website có doanh thu phụ thuộc SEO, nên audit cẩn thận trước khi thay đổi hàng loạt.
Kết luận
Doanh nghiệp không cần lo lắng chỉ vì có nhiều trang được index, nhưng nên kiểm tra xem những trang đó đang giúp ích hay đang âm thầm cạnh tranh với chính các trang quan trọng nhất.
Index bloat không phải vấn đề về số lượng trang được index, mà là vấn đề về chất lượng, mức độ liên quan và vai trò của các trang đó trong chiến lược SEO. Một website có nhiều URL index vẫn có thể hoạt động tốt nếu các URL đó có intent rõ, nội dung khác biệt và hỗ trợ cấu trúc site. Ngược lại, nếu phần lớn URL là filter, tag mỏng, tham số, duplicate hoặc nội dung tự động sinh ít giá trị, số lượng index cao có thể chỉ làm loãng tín hiệu.
Bước tiếp theo phù hợp là vào Google Search Console, so sánh số URL doanh nghiệp thật sự muốn index với số URL Google đang index, sau đó phân nhóm các mẫu URL gây nhiễu. Không nên xử lý vội bằng noindex hoặc robots.txt hàng loạt; hãy xác định từng nhóm nên canonical, noindex, redirect, chặn crawl hay cải thiện nội dung.
Nếu doanh nghiệp đang có số trang index cao bất thường so với số trang thật sự cần SEO, hoặc traffic không tăng dù website liên tục có nội dung mới, DGM ASIA có thể hỗ trợ qua dịch vụ SEO tổng thể, phân tích Page Indexing, Crawl Stats, sitemap, canonical, robots.txt, internal link và các nhóm URL đang gây Index bloat.
FAQ
Index bloat có phải lúc nào cũng xấu không?
Không hẳn. Vấn đề không nằm ở số lượng trang được index, mà ở việc các trang đó có giá trị và liên quan hay không. Website lớn có nhiều URL index vẫn bình thường nếu mỗi URL có intent rõ, nội dung khác biệt và hỗ trợ mục tiêu SEO. Index bloat chỉ đáng lo khi phần lớn URL được index là trang mỏng, trùng lặp hoặc không cần xuất hiện trên Google.
Làm sao biết trang nào đang gây ra Index bloat?
Hãy kiểm tra Page Indexing trong Google Search Console và nhóm URL theo mẫu lặp lại như tham số lọc, phân trang, tag, archive, tìm kiếm nội bộ hoặc URL sort. Nếu một nhóm URL chiếm tỷ lệ lớn trong index nhưng gần như không có traffic hoặc không có mục tiêu SEO rõ, đó có thể là nhóm gây Index bloat.
Noindex và chặn robots.txt khác nhau thế nào khi xử lý Index bloat?
Noindex cho phép Google crawl trang để đọc chỉ thị rồi không hiển thị trang trong kết quả tìm kiếm. Robots.txt chặn Google crawl URL ngay từ đầu, nên Google có thể không đọc được noindex hoặc canonical trong trang. Vì vậy, noindex phù hợp khi muốn loại khỏi index nhưng vẫn cho Google đọc trang; robots.txt phù hợp hơn khi chắc chắn không cần Google crawl nhóm URL đó.
Website nhỏ có cần lo về Index bloat không?
Mức độ rủi ro của website nhỏ thường thấp hơn, nhưng vẫn có thể xảy ra nếu CMS, plugin, tag, search nội bộ hoặc bộ lọc tạo ra nhiều URL tự động. Website nhỏ nên kiểm tra định kỳ bằng Search Console để đảm bảo Google không index các URL ngoài ý muốn như tag mỏng, trang tìm kiếm hoặc URL tham số.
Xử lý Index bloat mất bao lâu để thấy hiệu quả?
Không nên cam kết một mốc thời gian cố định. Tốc độ cải thiện phụ thuộc vào tần suất Google crawl lại website, số lượng URL cần xử lý, mức độ lỗi kỹ thuật, chất lượng trang chính và cách doanh nghiệp dùng canonical, noindex, redirect hoặc robots.txt. Với website lớn, nên theo dõi theo từng đợt thay vì kỳ vọng thay đổi ngay lập tức.
Khi nào nên nhờ DGM ASIA audit Index bloat cho website?
Doanh nghiệp nên nhờ DGM ASIA audit khi số trang được index cao bất thường so với số trang thật sự cần thiết, khi traffic không tăng dù website vẫn liên tục có nội dung mới, hoặc khi Search Console xuất hiện nhiều URL tham số, duplicate, canonical sai và nhóm “Crawled – currently not indexed”. Audit giúp xác định đúng nhóm URL cần giữ, cần noindex, cần canonical, cần redirect hoặc cần chặn crawl.